はじめに
ProxySQLは、MySQLとアプリケーションの間に配置することで、接続先の制御やクエリルーティング、コネクションプーリングなどを行うことができるプロキシソフトウェアです。
ProxySQLで利用される代表的な構成の一つに、Read/Write Splitがあります。
Read/Write Splitでは、更新処理をPrimary、参照処理をReplicaへ振り分けることで、Primaryへの負荷を分散できます。
- 更新処理の場合 :
INSERT/UPDATE/DELETE→ Primary - 参照処理の場合 :
SELECT→ Replica
一方、PrimaryとReplica間で非同期レプリケーションを利用している場合、Primaryへデータを書き込んだ直後にSELECTを実行すると、Replicaへの反映が間に合っておらず、最新のデータを取得できない場合があります。
「更新した直後は、必ず最新のデータを取得したい」――このような要件がある場合、わずかな反映遅延が問題になることがあります。
本記事では、このようなRead/Write Split環境における課題に対して、ProxySQLのnext_query_flagINを利用し、INSERT直後のSELECTをPrimaryへ振り分ける方法を検証します。
検証環境
今回は、Primary 1台、Replica 1台のMySQLレプリケーション環境の前段にProxySQLを配置します。
使用するバージョンは以下のとおりです。
- MySQL:9.7.2
- ProxySQL:3.0.11
構成は以下のとおりです。
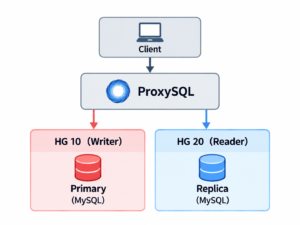
ProxySQLでは、Writer用のHostgroupを10、Reader用のHostgroupを20として設定します。
サーバーの設定を確認します。
|
1 2 3 4 5 6 7 8 |
SELECT hostgroup_id, hostname, port, status FROM mysql_servers ORDER BY hostgroup_id; |
|
1 2 3 4 5 6 7 |
+--------------+-----------+-------+--------+ | hostgroup_id | hostname | port | status | +--------------+-----------+-------+--------+ | 10 | 127.0.0.1 | 20903 | ONLINE | | 20 | 127.0.0.1 | 20904 | ONLINE | +--------------+-----------+-------+--------+ |
Writer HostgroupとReader Hostgroupの設定も確認します。
|
1 2 3 |
SELECT * FROM mysql_replication_hostgroups; |
|
1 2 3 4 5 6 |
+------------------+------------------+------------+----------------------+ | writer_hostgroup | reader_hostgroup | check_type | comment | +------------------+------------------+------------+----------------------+ | 10 | 20 | read_only | dbdeployer R/W Split | +------------------+------------------+------------+----------------------+ |
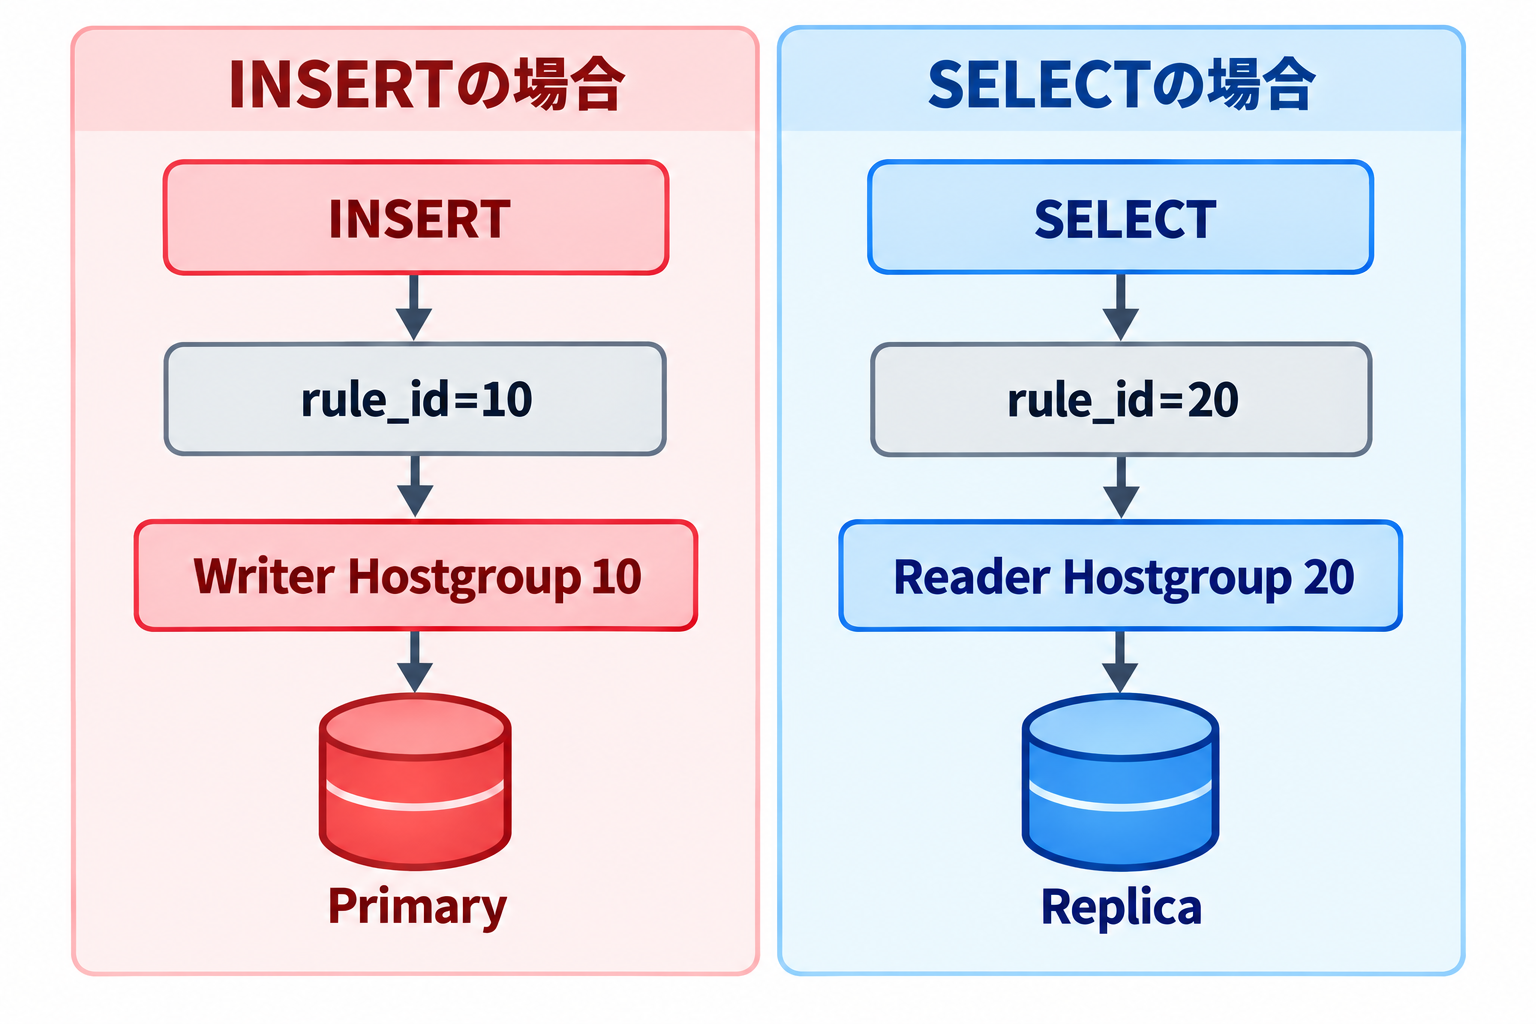
今回はnext_query_flagINの挙動を分かりやすく確認するため、INSERTをWriter Hostgroup、SELECTをReader Hostgroupへ明示的に振り分けるシンプルなクエリルールを使用します。
まず、INSERTをWriter Hostgroupへ振り分けるルールを設定します。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
INSERT INTO mysql_query_rules ( rule_id, active, flagIN, match_digest, destination_hostgroup, apply ) VALUES ( 10, 1, 0, '^INSERT', 10, 1 ); |
続いて、SELECTをReader Hostgroupへ振り分けます。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
INSERT INTO mysql_query_rules ( rule_id, active, flagIN, match_digest, destination_hostgroup, apply ) VALUES ( 20, 1, 0, '^SELECT', 20, 1 ); |
設定後、クエリルールを反映します。
|
1 2 3 |
LOAD MYSQL QUERY RULES TO RUNTIME; SAVE MYSQL QUERY RULES TO DISK; |
反映されたクエリルールを確認します。
|
1 2 3 4 5 6 7 8 9 10 |
SELECT rule_id, active, flagIN, match_digest, destination_hostgroup, apply FROM runtime_mysql_query_rules ORDER BY rule_id; |
|
1 2 3 4 5 6 7 |
+---------+--------+--------+--------------+-----------------------+-------+ | rule_id | active | flagIN | match_digest | destination_hostgroup | apply | +---------+--------+--------+--------------+-----------------------+-------+ | 10 | 1 | 0 | ^INSERT | 10 | 1 | | 20 | 1 | 0 | ^SELECT | 20 | 1 | +---------+--------+--------+--------------+-----------------------+-------+ |
この設定では、以下のようにルーティングされます。
なお、今回は検証を分かりやすくするために単純化したクエリルールを使用しています。
実際の環境では、実行されるクエリやトランザクションの扱いなども考慮し、ワークロードに合わせてクエリルールを設計する必要があります。
Read/Write Splitの挙動確認
まずは、通常のRead/Write Splitが想定どおり動作していることを確認します。
検証には以下のitemsテーブルを使用します。
|
1 2 3 4 5 6 |
CREATE TABLE items ( id INT UNSIGNED NOT NULL AUTO_INCREMENT, item_name VARCHAR(100) NOT NULL, PRIMARY KEY (id) ); |
ProxySQL経由でデータを登録します。
|
1 2 3 |
INSERT INTO items (item_name) VALUES ('pencil'); |
続けて、登録したデータを確認します。
|
1 2 3 |
SELECT * FROM items; |
|
1 2 3 4 5 6 |
+----+-----------+ | id | item_name | +----+-----------+ | 1 | pencil | +----+-----------+ |
あわせて、ProxySQLのAdmin Interfaceから、それぞれのクエリがどのHostgroupへルーティングされたか確認します。
|
1 2 3 4 5 6 7 |
SELECT hostgroup, digest_text FROM stats_mysql_query_digest WHERE schemaname = 'test' ORDER BY last_seen DESC\G |
|
1 2 3 4 5 6 7 8 |
*************************** 1. row *************************** hostgroup: 20 digest_text: select * from items *************************** 2. row *************************** hostgroup: 10 digest_text: INSERT INTO items (item_name) values (?) |
実行結果から、INSERTはWriter Hostgroupの10、SELECTはReader Hostgroupの20へ正しく振り分けられていることが確認できます。
Read/Write Splitの限界
Read/Write Splitでは、参照処理をReplicaへ分散できる一方で、レプリケーション遅延などによってPrimaryとReplica間のデータ反映に時間差が生じると、問題になる場合があります。
例えば、INSERT直後にSELECTを実行するケースです。
- INSERT → Primaryへ書き込み
- 直後にSELECT → Replicaから読み取り
PrimaryへのINSERTが完了していても、その時点でReplicaへの反映まで完了しているとは限りません。
そのため、直後のSELECTがReplicaへ振り分けられると、INSERTしたばかりのデータを取得できない可能性があります。
実際にレプリケーション遅延が起きている際の挙動を確認してみましょう。
今回はこの状態を再現するため、ReplicaのSQL Threadを一時的に停止します。
Replicaへ接続し、以下を実行します。
|
1 2 |
STOP REPLICA SQL_THREAD; |
この状態で、ProxySQL経由で新しいデータを登録します。
|
1 2 3 |
INSERT INTO items (item_name) VALUES ('eraser'); |
続けてSELECTを実行します。
|
1 2 3 |
SELECT * FROM items; |
|
1 2 3 4 5 6 |
+----+-----------+ | id | item_name | +----+-----------+ | 1 | pencil | +----+-----------+ |
eraserをINSERTしたにもかかわらず、SELECT結果にはpencilしか表示されていません。
ルーティング先を確認します。
|
1 2 3 4 5 6 7 8 |
SELECT hostgroup, digest_text FROM stats_mysql_query_digest WHERE schemaname = 'test' ORDER BY last_seen DESC LIMIT 3\G |
|
1 2 3 4 5 6 7 8 |
*************************** 1. row *************************** hostgroup: 20 digest_text: select * from items *************************** 2. row *************************** hostgroup: 10 digest_text: INSERT INTO items (item_name) values (?) |
INSERTはWriter Hostgroupの10、SELECTはReader Hostgroupの20へ送られています。
念のため、Primaryへ直接接続してデータを確認します。
|
1 2 3 |
SELECT * FROM items; |
|
1 2 3 4 5 6 7 |
+----+-----------+ | id | item_name | +----+-----------+ | 1 | pencil | | 2 | eraser | +----+-----------+ |
Primaryにはeraserが正常に登録されています。
このように、Primaryへの更新が正常に完了していても、Replicaへの反映が遅れている場合、Read/Write SplitによってReplicaへ振り分けられたSELECTでは最新データを取得できないことがあります。
今回は挙動を再現するためSQL Threadを停止しましたが、実環境でも負荷やI/O、ネットワーク状況などによってReplicaへの適用が遅延した場合には、同様の状況が発生する可能性があります。
next_query_flagINによる解決
next_query_flagINとは
ProxySQLのmysql_query_rulesには、next_query_flagINという設定があります。
next_query_flagINを利用すると、あるクエリがクエリルールにマッチした際に、後続クエリがどのflagINからクエリルールの評価を開始するかを指定できます。
今回の検証では、itemsテーブルへのINSERTが実行された場合に、
|
1 2 |
next_query_flagIN = 100 |
を設定します。
これにより、INSERTの後に実行されるクエリは、通常のflagIN=0ではなくflagIN=100から評価されます。
さらに、flagIN=100から評価されたSELECTが対象のルールにマッチした際にnext_query_flagIN=0を設定することで、それ以降のクエリは通常のflagIN=0からの評価へ戻します。
今回の設定では、以下のような流れになります。
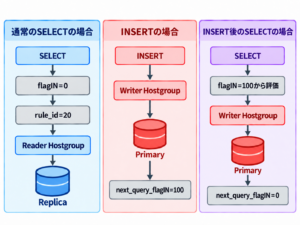
このように、今回のクエリルールでは、INSERT後のSELECTをPrimaryへ振り分け、そのSELECTが実行された後は通常のRead/Write Splitへ戻す構成とします。
ここで、next_query_flagINを利用する際の注意点です。
next_query_flagINによるルール評価の切り替えは、ProxySQLへのクライアント接続(セッション)単位で保持されます。
そのため、今回の構成では、INSERTとその後のSELECTを同じProxySQL接続から実行する必要があります。本検証でも同一接続上で実行しています。
なお、next_query_flagINはトランザクション単位で動作する機能ではありません。接続単位で制御される点に注意してください。
本検証では、flagIN=100のSELECTがルールにマッチした際にnext_query_flagIN=0へ戻すことで、その後は通常のクエリルール評価へ戻しています。
クエリルールの設定
先ほど設定したrule_id=10は、すべてのINSERTをWriter Hostgroupへ振り分けるルールでした。
今回はnext_query_flagINの対象をitemsテーブルへのINSERTに限定したいため、match_digestを^INSERTから^INSERT INTO itemsへ変更したうえで、next_query_flagIN=100を追加します。
一度既存のルールを削除します。
|
1 2 3 |
DELETE FROM mysql_query_rules WHERE rule_id = 10; |
続いて、next_query_flagINを追加した状態でrule_id=10を登録し直します。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
INSERT INTO mysql_query_rules ( rule_id, active, flagIN, match_digest, destination_hostgroup, next_query_flagIN, apply ) VALUES ( 10, 1, 0, '^INSERT INTO items', 10, 100, 1 ); |
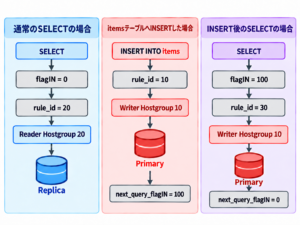
このルールでは、itemsテーブルへのINSERTをWriter Hostgroupの10へ送るとともに、next_query_flagIN=100を設定します。
続いて、flagIN=100から評価されたSELECTをWriter Hostgroupへ振り分けるルールを追加します。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
INSERT INTO mysql_query_rules ( rule_id, active, flagIN, match_digest, destination_hostgroup, next_query_flagIN, apply ) VALUES ( 30, 1, 100, '^SELECT', 10, 0, 1 ); |
このルールでは、INSERT後のSELECTをWriter Hostgroupの10へ振り分けます。
また、next_query_flagIN=0を指定することで、その後のクエリから通常のクエリルール評価へ戻します。
設定後、クエリルールを反映します。
|
1 2 3 |
LOAD MYSQL QUERY RULES TO RUNTIME; SAVE MYSQL QUERY RULES TO DISK; |
反映された最終的なクエリルールを確認します。
|
1 2 3 4 5 6 7 8 9 10 11 |
SELECT rule_id, active, flagIN, match_digest, destination_hostgroup, next_query_flagIN, apply FROM runtime_mysql_query_rules ORDER BY rule_id; |
|
1 2 3 4 5 6 7 8 |
+---------+--------+--------+--------------------+-----------------------+-------------------+-------+ | rule_id | active | flagIN | match_digest | destination_hostgroup | next_query_flagIN | apply | +---------+--------+--------+--------------------+-----------------------+-------------------+-------+ | 10 | 1 | 0 | ^INSERT INTO items | 10 | 100 | 1 | | 20 | 1 | 0 | ^SELECT | 20 | NULL | 1 | | 30 | 1 | 100 | ^SELECT | 10 | 0 | 1 | +---------+--------+--------+--------------------+-----------------------+-------------------+-------+ |
最終的なルーティングは以下のようになります。
挙動確認
続いて、設定したクエリルールの挙動を確認します。
先ほどの検証で登録したeraserまではReplicaへ反映させたうえで、再度SQL Threadを停止し、これ以降に登録するデータがReplicaへ反映されない状態にしています。
まず、ProxySQL経由で新しいデータを登録します。
|
1 2 3 |
INSERT INTO items (item_name) VALUES ('notebook'); |
続けてデータを確認します。
|
1 2 3 |
SELECT * FROM items; |
|
1 2 3 4 5 6 7 8 |
+----+-----------+ | id | item_name | +----+-----------+ | 1 | pencil | | 2 | eraser | | 3 | notebook | +----+-----------+ |
今回は、Replicaへの反映を待たずにnotebookまで取得することができました。
あわせて、ProxySQLのAdmin Interfaceから、INSERTとSELECTのルーティング先を確認します。
|
1 2 3 4 5 6 7 |
SELECT hostgroup, digest_text FROM stats_mysql_query_digest WHERE digest_text LIKE '%items%' ORDER BY last_seen DESC\G |
|
1 2 3 4 5 6 7 8 |
*************************** 1. row *************************** hostgroup: 10 digest_text: SELECT * FROM items *************************** 2. row *************************** hostgroup: 10 digest_text: INSERT INTO items (item_name) VALUES (?) |
INSERTだけでなく、その後のSELECTもWriter Hostgroupの10へルーティングされていることが確認できます。
念のため、ProxySQLを経由せずReplicaへ直接接続してデータを確認します。
|
1 2 3 |
SELECT * FROM items; |
|
1 2 3 4 5 6 7 |
+----+-----------+ | id | item_name | +----+-----------+ | 1 | pencil | | 2 | eraser | +----+-----------+ |
Replicaにはまだnotebookが反映されていません。
つまり、Replicaには最新データが存在しないにもかかわらず、ProxySQL経由のSELECTでは最新データを取得できています。
ルーティング履歴からもSELECTがWriter Hostgroupへ送られているため、next_query_flagINとクエリルールの組み合わせによって、INSERT後のSELECTをPrimaryへ振り分けられていることが確認できました。
まとめ
ProxySQLのRead/Write Splitでは、参照処理をReplicaへ分散することでPrimaryの負荷を軽減できます。
一方、非同期レプリケーションではPrimaryへの更新とReplicaへの反映に時間差が生じるため、更新直後のSELECTで最新データを取得できない場合があります。
今回検証したnext_query_flagINを利用すると、直前に実行されたクエリをきっかけとして、後続クエリのクエリルール評価を切り替えることができます。
今回の検証では、Replicaに最新データが存在しない状態でも、INSERT後のSELECTをPrimaryへ振り分けることで最新データを取得できることを確認しました。
すべてのSELECTをPrimaryへ送るのではなく、必要な場面だけPrimaryへ送ることで、Read/Write Splitによる負荷分散を維持しながら、より柔軟なクエリルーティングが可能になります。
「このSQLはどこへ送るか」だけでなく、「次のSQLをどこへ送るか」まで制御する。
ProxySQLを使って、一歩踏み込んだクエリルーティングを試してみてはいかがでしょうか。